Olá DBAs, a vida tá boa?
O artigo anterior sobre os histogramas foi bem legal de escrever, mas em se tratando de um assunto tão complexo, e cheio de variáveis, era impossível colocar tudo num artigo só (nem você ia querer ler tudo de tão grande…srsrsrs), por isso, voltamos aqui com a segunda parte, e com explicações importantes sobre a utilização do estimate_percent, e sobre como ele influencia no tipo de histograma que será criado.
Se voce não viu a parte 1, vai lá e dá uma lida, pois só então esse artigo aqui será tão esclarecedor quanto o pretendido:
Voltar para a Parte 1: [Histogramas no Oracle: o parâmetro que mais afeta seus planos de execução – Parte 1]
Se você chegou aqui vindo da Parte 1, já sabe que a nossa conversa começou com uma pergunta aparentemente simples: Quanto o Oracle precisa ler para conseguir entender a distribuição dos meus dados?
Na Parte 1, vimos que o ESTIMATE_PERCENT não é simplesmente um número que define “quanto da tabela o Oracle vai ler”. Vimos como o tamanho da amostra pode influenciar a qualidade das estatísticas, a precisão das estimativas e, consequentemente, a qualidade dos planos de execução.
Também chegamos a uma conclusão importante: Quanto maior a amostra, menor tende a ser a variação estatística daquilo que o Oracle observa.
E aí eu terminei o artigo deixando no ar uma afirmação: ESTIMATE_PERCENT não influencia apenas quanto o Oracle amostra. Ele também pode influenciar como o Oracle constrói os Histogramas.
E esta afirmação nos aponta para uma interrogação: Mas por quê?
Bom… Agora vamos dissecar essa parte.
Quanto terminei a parte 1, ainda tinha a ideia de fazer alguns complementos no artigo, que ao meu ver não precisavam de tantos detalhes por usar critério internos e etc… Aí eu recebi uma mensagem que mudou tudo.
Nosso grande amigo e mestre de todos Ricardo Portilho (eu duvido que voce não conhece ele, e se não conhece, precisa conhecer, deixei o LinkedIn dele referenciado aqui), me mandou uma mensagem perguntando se eu havia considerado que ao abdicar do uso do AUTO em ESTIMATE_PERCENT, o Histograma escolhido poderá ser o problematico Height Balanced, legado pré 12c, mesmo nas versões atuais.
A própria doc da Oracle trata esse tipo de histograma como legado, e eu sinceramente imaginava que por este motivo, a escolha de tal histograma era super rara, afetando menos os sistemas atuais, mas ao receber essa mensagem fui dar uma olhada mais a fundo e descobri minha falha conceitual, pois a escolha do tipo de histograma é baseado em fórmulas matemáticas que ainda persistem, ou seja, estatisticamente (quero ver se aqui voce saca o trocadilho…srsrsrs), as chances de ter o Height Balanced hoje em dia é a mesma que era em todas as outras versões.
Obrigado ao Portilho por esta mensagem, e é por isso que esse artigo está do tamanho que está…ahuauhuahuhauhaa
Vamos aos fatos? Quando você olha para uma chamada aparentemente inocente como:
DBMS_STATS.GATHER_TABLE_STATS(
    ownname          => 'SCOTT',
    tabname          => 'ORDERS',
    estimate_percent => 10,
    method_opt       => 'FOR ALL COLUMNS SIZE AUTO'
);
é muito fácil imaginar que o 10 significa apenas: “Oracle, leia aproximadamente 10% da tabela e faça suas contas.”
Mas não é só isso!!!
Dependendo das condições da coleta, da distribuição dos dados, do número de valores distintos e, principalmente, de como o ESTIMATE_PERCENT foi definido, essa escolha pode participar da decisão de qual modelo de histograma será construído.
E é aqui que a história começa a ficar realmente interessante.
Na Parte 1, nós estávamos olhando principalmente para esta pergunta:
Quanto o Oracle consegue enxergar e como ele viu a distribuição?
Agora vamos acrescentar uma segunda:
E COMO ele representa aquilo que enxergou?
Essa diferença é fundamental. Fundamental para o plano de execução.
Imagine que o Oracle esteja olhando para uma coluna com milhões de linhas e uma distribuição extremamente assimétrica (skewed data).
Ele precisa transformar essa enorme quantidade de informação em uma estrutura estatística compacta, que possa ser consultada rapidamente pelo Optimizer.
Essa estrutura é o histograma, correto? Correto.
E aqui surge a pergunta que vai guiar toda esta segunda parte do artigo:
Se o Oracle tem diferentes formas de representar a distribuição dos dados, como ele decide qual delas utilizar?
Vamos sair do conceito genérico de “tem ou não tem histograma” e entrar nos quatro principais modelos que encontraremos no Oracle:
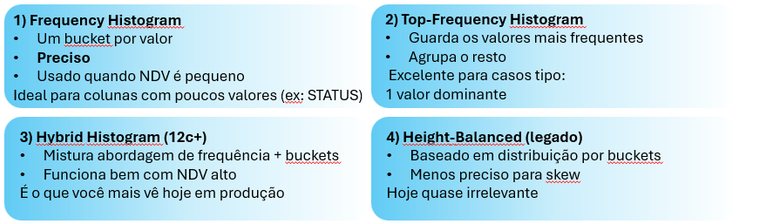
Vamos entender como cada histograma enxerga os dados, quais informações ele consegue preservar, em que situações o Oracle pode escolhê-lo e, principalmente, como essas diferenças podem alterar a estimativa de cardinalidade do Optimizer.
Porque no final das contas, é disso que estamos falando. O histograma não existe para deixar a DBA_TAB_HISTOGRAMS bonita, ele existe para responder uma pergunta extremamente importante:
“Se eu executar WHERE COLUNA = X, quantas linhas você acha que vou encontrar?”
E quando essa resposta está errada… bom, vocês já viram na Parte 1 o que acontece:
E-Rows: 200. A-Rows: 100.000.000.
Sampling foi apenas a primeira parte da história. Agora vamos falar sobre como o Oracle transforma aquilo que encontrou em informação para o Optimizer.
Lembram que falamos dos skewed values? Então, Um histograma permite ao Optimizer entender que alguns valores podem ser muito mais frequentes do que outros.
Só que existe um detalhe:
o Oracle possui diferentes maneiras de representar essa distribuição.
E a escolha de qual representação utilizar não é aleatória.
Ela depende de informações como:
- NDV;
- quantidade de buckets solicitada;
- distribuição dos dados;
- e também da forma como o estimate_percent foi definido.
A própria documentação da Oracle apresenta esses critérios em uma árvore de decisão.
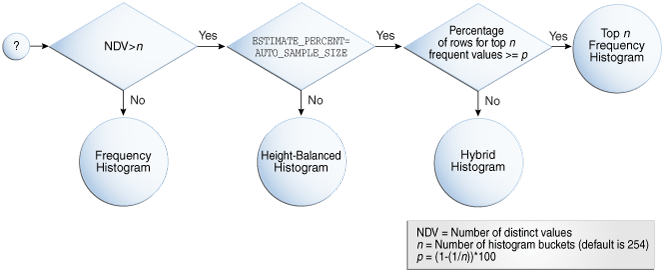
E é essa árvore que vamos dissecar, mas antes algumas observações:
AUTO_SAMPLE_SIZE x ESTIMATE_PERCENT manual
Vamos corroborar a informação que eu passei logo acima no começo do artigo, com um pouco mais de detalhes. Duas coletas praticamente iguais.
Primeiro:
BEGIN
  DBMS_STATS.GATHER_TABLE_STATS(
      ownname          => 'SCOTT',
      tabname          => 'ORDERS',
      estimate_percent => DBMS_STATS.AUTO_SAMPLE_SIZE,
      method_opt       => 'FOR ALL COLUMNS SIZE AUTO'
  );
END;
/
Agora:
BEGIN
  DBMS_STATS.GATHER_TABLE_STATS(
      ownname          => 'SCOTT',
      tabname          => 'ORDERS',
      estimate_percent => 10,
      method_opt       => 'FOR ALL COLUMNS SIZE AUTO'
  );
END;
/
O nosso bom e velho amigo SCOTT sempre aparece. Se quiser saber um curiosidade sobre o SCOTT, pode abrir esta seção 🙂
Encontrei uma história muito interessante sobre o famos SCOTT e ela tem um detalhe que provavelmente vai agradar aos DBAs antigos: TIGER era o nome do gato da filha de Bruce Scott!
A história por trás de SCOTT/TIGER
- SCOTT era Bruce Scott, funcionário número 4 da Oracle, na época chamada Software Development Laboratories.
- Bruce participou da arquitetura e do desenvolvimento das primeiras versões do Oracle (V1, V2 e V3).
- Ele criou o schema de demonstração com as tabelas
EMPeDEPT, para testar e demonstrar funcionalidades do banco. - A senha
TIGERveio do nome do gato de sua filha.
Essa história é relatada em fontes históricas da comunidade Oracle, incluindo a Oracle FAQ e artigos sobre os primeiros anos da empresa.
Uma curiosidade: o usuário SCOTT continua aparecendo em exemplos e scripts mantidos pela própria Oracle, embora já não seja o schema de demonstração principal.
Voltando ao que interessa, no primeiro caso, a diferença parece pequena.:
“Oracle, escolha a estratégia de amostragem.”
No segundo:
“Oracle, utilize 10%.”
Mas existe uma consequência que talvez não seja tão óbvia.
O estimate_percent também participa da decisão sobre qual tipo de histograma será criado.
Na documentação do Oracle 18c, quando NDV é maior que o número de buckets, o comportamento passa a depender justamente de estimate_percent.
Com:
AUTO_SAMPLE_SIZEo Oracle pode produzir:
TOP-FREQUENCY ou HYBRIDJá quando usamos um percentual explicitamente definido pelo usuário, o Oracle pode produzir:
HEIGHT-BALANCEDEsse é um ponto particularmente interessante porque o Height-Balanced é classificado pela própria Oracle como um histograma legacy.
Ou seja:
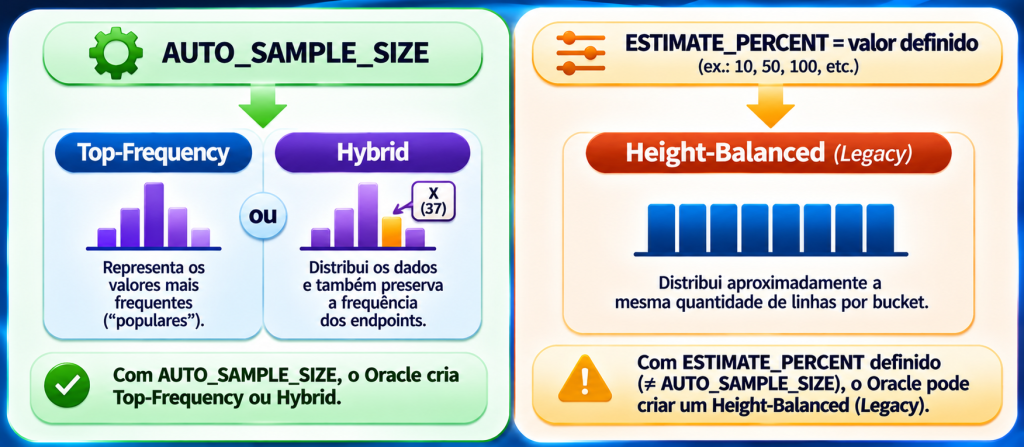
Claro: isso não significa que qualquer estimate_percent manual sempre produzirá Height-Balanced.
Se NDV <= número de buckets, por exemplo, podemos continuar tendo um Frequency Histogram.
A combinação dos critérios é que determina o resultado como mostrado na árvore de decisão.
E aqui precisamos introduzir duas variáveis importantes: NDV, buckets e o famoso “254”
Quando falamos de Histogramas, duas informações aparecem o tempo inteiro:
NDVe:
nNDV nós já conhecemos:
Number of Distinct Values
Ou seja, quantos valores diferentes existem naquela coluna.
Já o n representa o número de buckets disponíveis para o histograma.
Na documentação do Oracle 18c, o valor padrão utilizado na explicação da árvore de decisão é:
n = 254E existe ainda uma terceira variável:
p = (1 - 1/n) × 100Com n=254 temos aproximadamente:
p = 99,6%E agora começa a ficar interessante.
Imagine:
NDV = 100
Buckets = 254
Temos:
100 <= 254Então o Oracle consegue representar todos os valores distintos.
Resultado:
FREQUENCY HISTOGRAMAgora imagine:
NDV = 10.000
Buckets = 254
Não conseguimos colocar um valor distinto em cada bucket.
Temos:
10.000 valores para 254 bucketsEntão o Oracle precisa encontrar uma forma inteligente de comprimir essa informação.
E é exatamente aqui que entram os outros tipos de Histogramas.
A árvore começa a ficar assim:
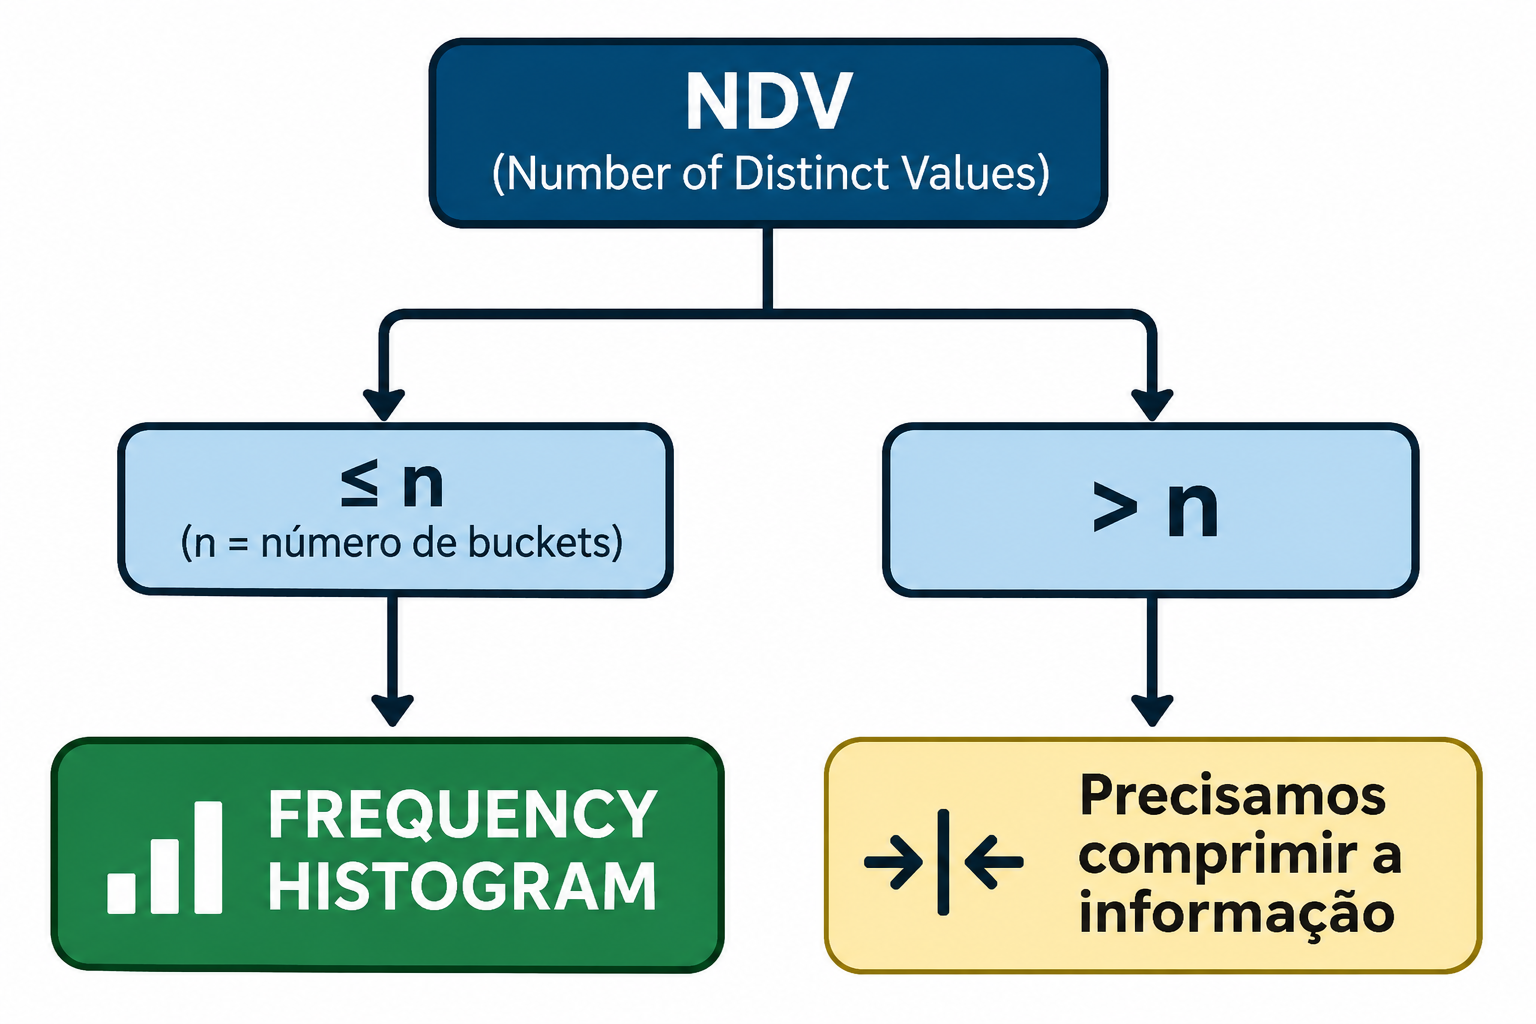
A partir daqui, estimate_percent passa a fazer diferença.
Com AUTO_SAMPLE_SIZE, o Oracle pode seguir para:
TOP-FREQUENCY ou HYBRIDCom um percentual definido manualmente:
HEIGHT-BALANCEDImportantíssimo ressaltar que, assim como falamos no primeiro artigo, 254 não é mais o limite máximo de buckets no Oracle. É o valor padrão (default) usado na construção dos histogramas.
A distinção é importante:
- 254: quantidade padrão de buckets solicitados.
- 2048: limite máximo que pode ser solicitado a partir do Oracle Database 12c.
SIZE 254: mantém o padrão tradicional.SIZE 2048: permite solicitar a quantidade máxima suportada.
A própria documentação do Oracle Database 26ai continua apresentando n = 254 como valor padrão na lógica de escolha do tipo de histograma.
A documentação do DBMS_STATS para Oracle 19c confirma que o parâmetro METHOD_OPT aceita valores de 1 a 2048 buckets.
Solicitar 2048 buckets não significa que o Oracle necessariamente criará um histograma com exatamente 2048 buckets. A quantidade efetiva pode ser menor, dependendo da distribuição dos dados e do tipo de histograma.
O valor padrão de buckets é 254, mas esse não é o limite máximo. Desde o Oracle Database 12c, é possível solicitar até 2048 buckets por meio do parâmetro
SIZEdoMETHOD_OPT.
E o mais importante nisso tudo: na árvore de decisão dos histogramas, n representa a quantidade de buckets solicitada. Portanto, quando usamos SIZE 2048, o valor de referência n também passa a ser 2048 e não 254.
E agora, finalmente, precisamos entender exatamente o que cada um desses nomes significa e como a distribuição é feita.
Frequency Histogram
Vamos começar pelo mais simples.
O Frequency Histogram trabalha com uma ideia bastante intuitiva:
Cada valor distinto recebe seu próprio bucket.
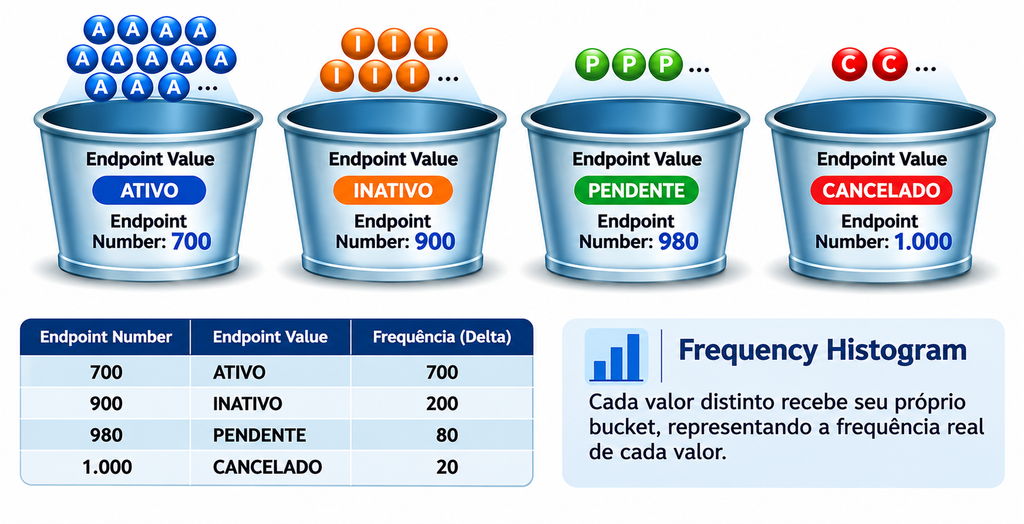
Imagine:
STATUS

ATIVO       700
INATIVO     200
PENDENTE     80
CANCELADO    20
Temos:
NDV = 4E podemos representar:
Bucket 1 → ATIVO
Bucket 2 → INATIVO
Bucket 3 → PENDENTE
Bucket 4 → CANCELADO
Cada valor possui sua própria representação.
É por isso que o Frequency Histogram é o caso mais simples de entender.
Se temos:
NDV <= número de bucketso Oracle consegue representar todos os valores distintos individualmente.
Na documentação da Oracle, esse é exatamente o critério para criação de um Frequency Histogram.
E aqui aparece uma informação importante.
O Oracle não simplesmente guarda:
ATIVO = 700
INATIVO = 200
...
O que encontramos em USER_HISTOGRAMS são estruturas como:
ENDPOINT_NUMBER
ENDPOINT_VALUE
Por exemplo:
ENDPOINT_NUMBER   ENDPOINT_VALUE
---------------   --------------
1                 ATIVO
8                 INATIVO
10                PENDENTE
20                CANCELADO
O ENDPOINT_NUMBER representa uma frequência acumulada.
Então, se o endpoint anterior era:
1e o atual é:
8temos:
8 - 1 = 7ocorrências daquele valor.
A Oracle demonstra exatamente esse comportamento em seu exemplo de Frequency Histogram.
Isso permite ao Optimizer fazer algo muito interessante.
Ele consegue perceber que:
ATIVOé muito mais frequente que:
CANCELADOE portanto:
WHERE STATUS = 'ATIVO'não precisa ter a mesma cardinalidade estimada que:
WHERE STATUS = 'CANCELADO'E é justamente essa informação que não existia quando trabalhávamos apenas com:
NUM_ROWS + NDVTop-Frequency Histogram
Agora vamos complicar um pouco porque voces são inteligentes demais pra ficarem somente no basicão 🙂
Imagine uma coluna com:
NDV = 10.000mas temos apenas:
254 bucketsNão dá para representar os 10.000 valores.
Mas imagine que a distribuição seja:
Valor A → 300 milhões
Valor B → 200 milhões
Valor C → 150 milhões
Valor D → 100 milhões
...
e todos os outros milhares de valores juntos representem uma parcela muito pequena da tabela.
Será que precisamos gastar buckets tentando representar individualmente todos esses valores insignificantes?
Não.
E é justamente essa a ideia do Top-Frequency Histogram.
O Oracle pode dizer:
“Vou guardar detalhadamente os valores que realmente importam e ignorar os valores estatisticamente insignificantes.”
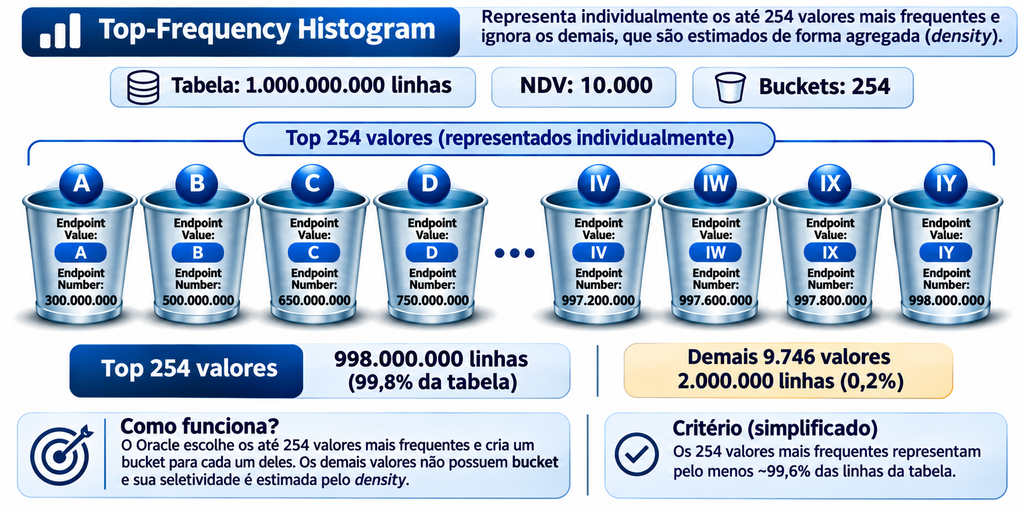
A documentação define o Top-Frequency como uma variação do Frequency Histogram que ignora valores não populares quando eles são estatisticamente insignificantes.
O critério documentado envolve:
NDV > ne:
Top-N valores ocupam >= p% das linhasonde:
p = (1 - 1/n) × 100Com:
n = 254temos aproximadamente:
p = 99,6%Então, de maneira simplificada:
Se os 254 valores mais frequentes representam pelo menos aproximadamente 99,6% das linhas, existe informação suficiente para que o Oracle use um Top-Frequency Histogram.
E tem mais uma condição:
estimate_percent = AUTO_SAMPLE_SIZEA documentação da Oracle é explícita sobre esses critérios.
Imagine:
1.000.000.000 linhas

Top 254 valores
= 998.000.000 linhas
Isso representa:
99,8%Os outros milhares de valores representam apenas:
0,2%Nesse cenário, faz muito mais sentido gastar os buckets descrevendo os valores que dominam a tabela do que tentar representar individualmente milhares de valores quase irrelevantes.
O Top-Frequency faz exatamente isso.
Height-Balanced Histogram
Agora chegamos ao nosso “vilão” da história.
Ou talvez seja melhor dizer:
o nosso personagem legado que ainda aparece quando você menos espera.
A Oracle chama explicitamente esse tipo de:
Height-Balanced Histogram (Legacy)
A ideia é relativamente simples.
Em vez de tentar colocar um valor em cada bucket, o Oracle tenta distribuir aproximadamente a mesma quantidade de linhas entre os buckets.
Imagine:
1.000.000 linhas

10 buckets
O objetivo seria algo próximo de:
Bucket 1 → 100.000 linhas
Bucket 2 → 100.000 linhas
Bucket 3 → 100.000 linhas
...
Bucket 10 → 100.000 linhas
Ou seja:
os buckets têm aproximadamente a mesma “altura”.
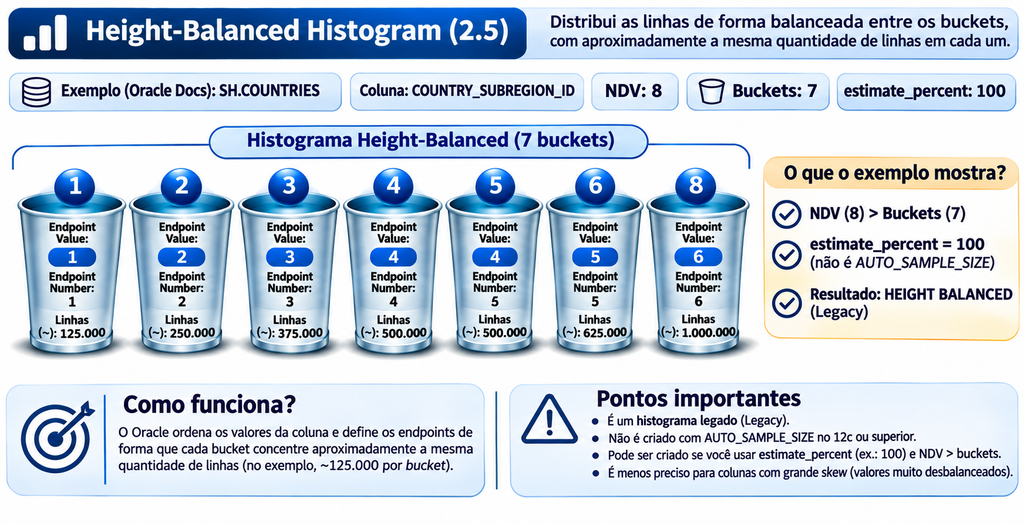
Daí vem o nome:
HEIGHT-BALANCEDA documentação explica exatamente essa característica.
Historicamente, antes do Oracle 12c, quando:
NDV > número de bucketso Oracle podia criar um Height-Balanced Histogram.
No Oracle 12c, entretanto, existe uma mudança importante.
Se estamos criando novos histogramas e usamos:
AUTO_SAMPLE_SIZEo Oracle não cria novos Height-Balanced Histograms.
Ele trabalha com:
TOP-FREQUENCY ou HYBRIDMas se você explicitamente define:
estimate_percent => 100ou outro percentual diferente de AUTO_SAMPLE_SIZE, e:
NDV > bucketso Height-Balanced pode voltar à cena.
A própria Oracle demonstra isso com um exemplo:
BEGIN
  DBMS_STATS.GATHER_TABLE_STATS(
      ownname          => 'SH',
      tabname          => 'COUNTRIES',
      method_opt       => 'FOR COLUMNS COUNTRY_SUBREGION_ID SIZE 7',
      estimate_percent => 100
  );
END;
/
Nesse caso:
NDV = 8
Buckets = 7
e:
estimate_percent = 100Resultado:
HEIGHT BALANCEDOu seja…
Você pode estar em uma versão moderna do Oracle, usando DBMS_STATS, e ainda assim conseguir produzir um histograma baseado em uma metodologia que a Oracle classifica como legacy.
E é justamente aqui que aquela decisão aparentemente inocente da parte 1 do nosso artigo:
estimate_percent => 10Pode matar a nossa performance, pois o problema do Height-Balanced Histogram é que ele tenta distribuir a mesma quantidade de linhas entre os buckets, mas isso não significa que represente bem a distribuição dos valores.
Imagine uma coluna com forte data skew:
- Valor A: 70% das linhas.
- Valor B: 20%.
- Outros valores: 10%.
Ao dividir os dados em buckets de alturas semelhantes, um mesmo valor muito frequente pode ocupar vários buckets.
Isso pode dificultar a estimativa correta de seletividade para determinados predicados.
E qual é o impacto no plano?
- O Optimizer estima uma cardinalidade diferente da realidade.
- Pode acreditar que uma consulta retornará poucas linhas quando, na verdade, retornará milhões — ou vice-versa.
- Com a cardinalidade errada, pode escolher um
INDEX RANGE SCANquando deveria fazer umFULL TABLE SCAN. - Também pode escolher uma ordem inadequada de joins e um método de join ineficiente.
A grande questão: o Height-Balanced tenta equilibrar a quantidade de linhas por bucket, mas pode perder precisão justamente onde mais precisamos dela: na representação de valores com frequências muito diferentes.
É por isso que histogramas como Top-Frequency e Hybrid trouxeram melhorias importantes para representar distribuições assimétricas.
Hybrid Histogram
E finalmente chegamos ao Hybrid. Na minha opinião, este é o mais interessante dos quatro pois ele nasceu justamente para resolver uma limitação importante do Height-Balanced.
Imagine que temos um valor que aparece muitas vezes, mas não vezes suficientes para ser considerado “popular” pelo mecanismo tradicional, esse valor pode ficar justamente na fronteira entre dois buckets.
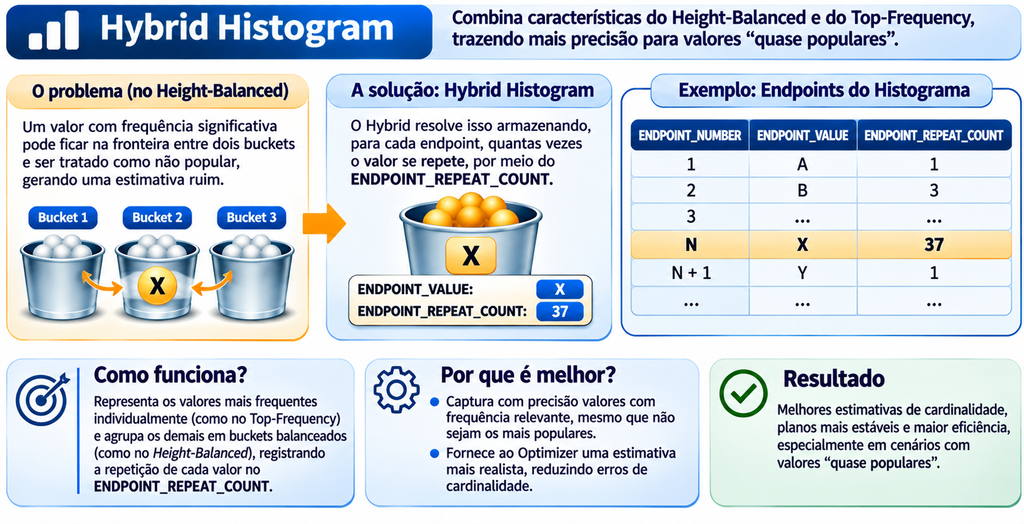
Imagine:
Bucket 1
Bucket 2
Bucket 3
e um determinado valor:
Xaparece quase tantas vezes que poderia ocupar dois buckets.
No Height-Balanced, dependendo de onde esse valor cai, ele pode acabar sendo tratado como não popular, mesmo tendo uma frequência bastante significativa e isso pode produzir uma estimativa ruim. A solução encontrada pelo Oracle foi o Hybrid Histogram.
A documentação explica que o Hybrid combina características dos Histogramas Height-Based e Frequency.
Mas existe uma informação particularmente importante:
ENDPOINT_REPEAT_COUNTO Oracle passa a armazenar, para cada endpoint, quantas vezes aquele valor se repete.
Imagine:
ENDPOINT_VALUE = X

ENDPOINT_REPEAT_COUNT = 37
Isso significa que:
Xaparece 37 vezes naquele endpoint.
O Optimizer passa a ter uma informação muito mais precisa sobre aquele valor.
E isso resolve justamente o problema dos valores que são:
quase populares.
A própria documentação usa essa ideia para explicar por que o Hybrid consegue melhorar estimativas em situações em que o Height-Balanced pode falhar.
O mesmo dado, quatro maneiras de enxergar
Agora que já conhecemos os quatro tipos, podemos resumir toda a ideia.
Imagine uma coluna extremamente skewed:
VALOR       FREQUÊNCIA

A           500.000
B           200.000
C           100.000
D            50.000
E            40.000
F            30.000
G            20.000
H            10.000
I             5.000
J             4.000
...
O dado é o mesmo.
Mas o Oracle pode representá-lo de maneiras diferentes.
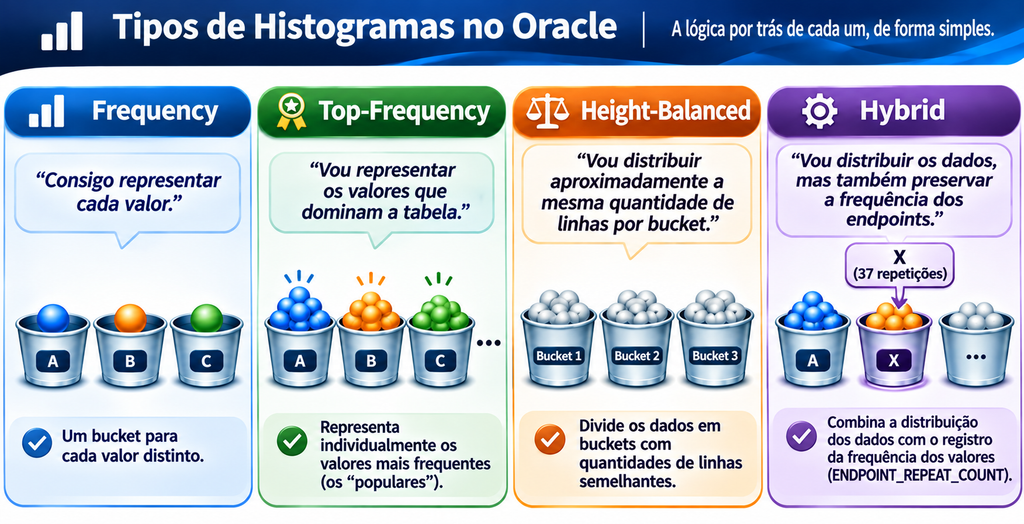
Frequency
A → bucket
B → bucket
C → bucket
D → bucket
...
Cada valor distinto possui sua representação.
Top-Frequency
A → bucket
B → bucket
C → bucket
D → bucket
...
Igual o Frequency, mas os valores pouco relevantes podem ser descartados da representação.
Height-Balanced
Aqui o Oracle pensa diferente:
Mesma quantidade de linhas

Bucket 1
Bucket 2
Bucket 3
Bucket 4
...
Os endpoints passam a representar onde estão as divisões da população.
Hybrid
Aqui o Oracle tenta combinar as duas ideias:
distribuição + frequência dos endpointse utiliza o:
ENDPOINT_REPEAT_COUNTpara não perder informação sobre valores que aparecem repetidamente.
Portanto, podemos pensar nos quatro modelos assim:
E finalmente, onde tudo isso nos leva?
Até aqui podemos ter a impressão de que estamos simplesmente discutindo diferentes formas de armazenar estatísticas.
Mas não.
Porque o histograma existe por uma razão muito específica:
ajudar o Optimizer a estimar cardinalidade.
Quando uma query chega:
SELECT *
FROM ORDERS
WHERE STATUS = 'ATIVO';
o Optimizer precisa responder:
Quantas linhas essa query vai retornar?Sem histograma, ele pode acabar trabalhando com a hipótese de distribuição uniforme.
Com histograma, ele pode descobrir:
STATUS = 'ATIVO' ==> 50% da tabela ==> 100 milhões de linhasenquanto:
STATUS = 'CANCELADO' ==> 0,01% da tabela ==> 20.000 linhasE isso muda completamente a decisão do Optimizer.
Pode mudar:
INDEX RANGE SCAN vs FULL TABLE SCANPode mudar:
NESTED LOOPS vs HASH JOINPode mudar JOIN ORDER, ACCESS PATH…
E pode, no final das contas, transformar:
E-Rows: 200
A-Rows: 100.000.000
em algo muito mais próximo da realidade.
A grande conexão entre a Parte 1 e a Parte 2 deste artigos é que na Parte 1 nós discutimos:
Quanto o Oracle consegue enxergar?Agora sabemos que existe uma segunda pergunta e podemos de certa forma responde-la:
Como ele representa aquilo que enxergou?Porque não adianta enxergar 10%, 30%, 50% ou 100% dos dados se a informação resultante não for representada de uma forma adequada para o Optimizer.
O caminho completo passa a ser:
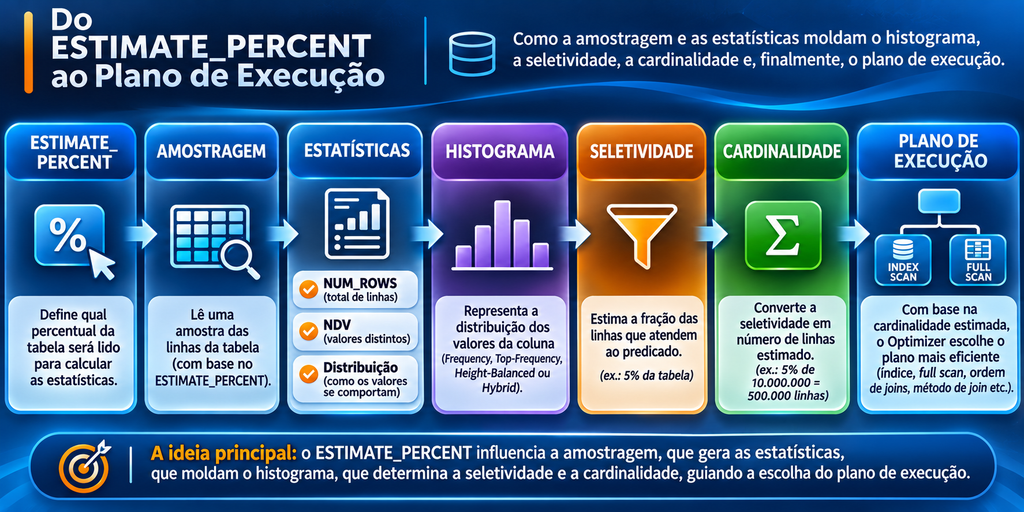
E agora chegamos ao ponto que eu considero mais interessante de toda essa história:
o histograma não é o objetivo final.
Ele é apenas a forma que o Oracle encontrou para transformar uma distribuição complexa de dados em informação que o Optimizer consiga utilizar.
Quero escrever um próximo artigo, pra gente dar uma olhada nessa “caixa-preta”: ENDPOINT_NUMBER, ENDPOINT_VALUE, ENDPOINT_REPEAT_COUNT, DENSITY, valores populares e não populares.
E aí vamos finalmente entender como o Oracle pega um:
WHERE COLUNA = 'X'e transforma isso em:
E-Rows = NPorque é nessa matemática que o histograma deixa de ser apenas uma tabela em DBA_TAB_HISTOGRAMS e passa a influenciar diretamente o plano que o Oracle escolhe.
Bom, esse é de longe um dos artigos mais complexos que já escrevi, pois precisava tranformar o que já existe na documentação, em algo mais “palatável”, mais entendível, mas simples pra voces.
Espero que tenham gostado, que tenham entendido, e que lembrem-se deste artigo quando forem fazer a coleta de estatísticas no seu ambiente.
Fiquem a vontade para fazer quaisquer pontuações e, falaí, o que voce achou? Já deu uma clareada?
Essa é a dica 0800 pra voces desta vez.
“Saber das coisas vale ouro. Compartilhar esse conhecimento não tem preço.”

Um comentário em “Histogramas no Oracle: o parâmetro que mais afeta seus planos de execução – Parte 2”